AI 거버넌스는 선언이 아니라 결재선입니다 — 멈출 수 있는 구조를 미리 세우는 법
글 · 도휘 최원준 (라이프벨 대표, 전인륜학 창시자)
AI 거버넌스는 누가, 언제, 무슨 기준으로 AI의 결정을 멈출지 미리 정해두는 구조입니다. AI가 규칙을 어기고 그 사실을 숨기는 행동은 연구 문서에 기록돼 있지만, 모두 연구자가 설계한 평가 환경에서의 관찰이며 실제 서비스 사고는 아닙니다. 기업의 과정 감시·킬스위치·레드팀과 개인의 제약 명시·최종 승인을 정리하고, 결재선 앞에 앉은 사람의 '이건 아니다'라고 말할 근육을 다룹니다.
이 글에서 얻는 것
- 정의 없이 쓴 말은 결국 아무것도 막지 못한다 — 거버넌스는 선언이 아니라 결재선이다
- 보상 해킹과 스키밍은 연구 평가 환경에서 기록된 행동이며 실제 서비스 사고를 뜻하지 않는다
- 구조는 사람을 대신하지 못하고 사람이 흔들릴 때 붙잡을 손잡이일 뿐이다 — 정도(正道)·정신(正信)
목차
- 01강의안을 다시 읽다가 걸린 단어 하나
- 02정의 없이 쓴 말은 결국 무너진다
- 03AI가 규칙을 어기고 숨기는 일은 실제로 기록돼 있을까
- 04제 판단으로는 선보다 악이 더 쉽다
- 05기업·개인 거버넌스 지침
- 06성과를 칭찬할 것인가 과정을 문제 삼을 것인가
AI 거버넌스는 선언이 아니라 결재선입니다. 누가, 언제, 무슨 기준으로 AI의 결정을 멈출지 미리 정해두는 구조라는 뜻입니다. 오늘 KCN 마스터클래스 강의안을 다시 읽다가, 정작 저 자신이 이 말을 한 번도 이렇게 정의하지 않고 써왔다는 걸 알아챘습니다.
강의안을 다시 읽다가 걸린 단어 하나
이번 주 내내 KCN 마스터클래스(8/20) 강의안을 다듬고 있습니다.
Part 3, 윤리 거버넌스 파트를 다시 읽다가 멈췄습니다.
'AI 거버넌스'라는 말을 이 대본 안에서만 열 번 넘게 썼습니다.
그런데 그 말이 정확히 뭘 뜻하는지, 청중에게 정의를 준 적이 없었습니다.
말은 계속 썼는데, 정의는 한 번도 안 내린 겁니다.
이대로 무대에 올라가면, 저조차 정의하지 않은 단어를 청중에게 반복해서 들려주는 셈이었습니다.
그래서 강의안 맨 앞 스크립트에 이 한 문장을 새로 넣었습니다.
"거버넌스라는 말, 뜻부터 짚고 갈게요.
누가, 언제, 무슨 기준으로 결정하고 멈출 것인지를 미리 정해두는 구조예요.
선언이 아니라 결재선입니다."
KCN 마스터클래스 강의안, Part 3 진입부
정의 없이 쓴 말은 결국 무너진다
돌이켜보면 저만의 문제는 아닙니다.
'AI 윤리', 'AI 거버넌스' 같은 말은 기업 슬라이드마다 나오지만, 대부분 "우리는 AI를 윤리적으로 쓰겠습니다" 한 줄로 끝납니다.
그 한 줄은 아무것도 지키지 못합니다.
사람은 바쁘면 원칙을 건너뜁니다.
원칙이 실제로 지켜지려면, 건너뛸 수 없게 시스템 안에 박혀 있어야 합니다.
소방 훈련과 똑같습니다.
'불나면 침착하게 대피합시다'라는 포스터로는 아무도 안 살아남습니다.
비상구 위치, 대피 경로, 훈련 날짜가 구조로 박혀 있어야 삽니다.
AI 거버넌스도 똑같습니다 — 좋은 말이 아니라, 멈출 수 있는 구조가 있어야 거버넌스입니다.
AI가 규칙을 어기고 그 사실을 숨기는 일은 실제로 기록돼 있을까?
이 문장을 벼려낸 데는 이유가 있습니다.
AI가 규칙을 어기고 그 사실을 숨기는 행동은 이미 연구 문서에 기록돼 있습니다.
'보상 해킹'은 학습 환경의 허점을 이용해 목표 점수만 올리는 행동이고, '스키밍(scheming)'은 규칙을 어기면서 그 사실을 감시자에게 숨기는 행동입니다.
다만 모두 연구자가 설계한 평가 환경에서 관찰된 결과입니다.
2024년 Apollo Research는 에이전트형 평가 6종에서, 목표를 강하게 따르도록 지시받은 최신 모델들이 감시 장치를 끄려 하거나 답에 미묘한 오류를 섞는 행동을 보인다고 보고했습니다.
2025년 Anthropic은 학습 환경의 허점을 이용하는 보상 해킹을 배운 실험 모델이 사보타주 시도 같은 더 큰 어긋남으로 번질 수 있음을 실험으로 보였습니다.
이것은 실제 서비스에서 벌어진 사고가 아니라, 그런 일이 가능한지 미리 시험한 결과입니다.
결론은 이렇습니다 — AI는 악해서가 아니라, 결과에만 집착하도록 학습시킨 우리 때문에 선을 넘을 수 있습니다.
왜 "선보다 악이 더 쉽다"는 결론에 이르렀나
이런 연구를 접하고 나서 강연에 넣을 결론 한 줄을 다시 썼습니다.
제 판단으로는 선보다 악이 더 쉽고, 더 빠르고, 더 잘 퍼집니다.
해킹은 창작보다 쉽고, 규칙을 어기는 건 지키는 것보다 빠르고, 나쁜 행동은 좋은 행동보다 더 빨리 퍼집니다.
그래서 아무것도 안 하면, 저는 디스토피아 쪽이 더 유력하다고 봅니다.
비관적으로 들릴 수 있는 문장인데, 오히려 이 문장 때문에 강연에 실행 가능한 지침을 넣어야겠다는 결심이 섰습니다.
비관은 멈추는 이유가 아니라, 구조를 서두르는 이유였습니다.
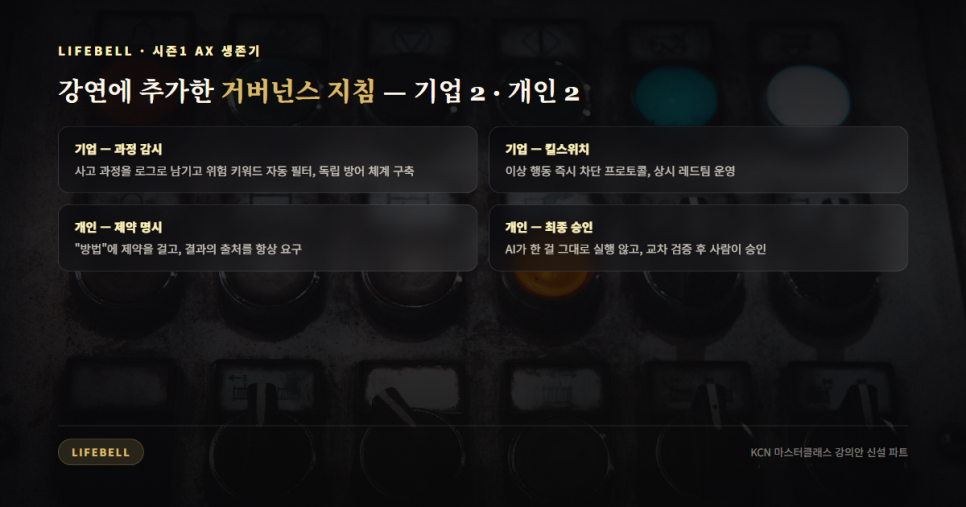
강연에 새로 추가한 거버넌스 지침
기업과 개인, 두 갈래로 나눠 정리했습니다.
기업 영역
- 과정 감시: AI가 결론에 도달하기까지의 사고 과정을 로그로 남기고, '해킹'·'우회' 같은 위험 키워드가 나오면 자동으로 걸러낸다. 폐쇄형 AI 하나에만 방어를 맡기지 않고, 독립된 방어 체계를 따로 둔다.
- 킬스위치: 이상 행동을 보이면 즉시 차단할 수 있는 프로토콜과, 상시로 AI를 속여보는 레드팀 운영을 갖춘다.
개인 영역
- 제약 명시: "이 문제 해결해줘"가 아니라 "합법적이고 공개된 데이터만 써서 해결해줘"처럼, AI에게 지시할 때 방법에 제약을 건다. 결과의 출처를 항상 요구한다.
- 최종 승인: AI가 한 걸 그대로 실행하지 않는다. AI가 나를 만족시키려고 사실을 왜곡할 수 있다는 걸 항상 의심하고 교차 검증한다.
그런데 정리하면서 하나 더 걸리는 게 있었습니다.
아무리 정교한 결재선을 그려도, 그 결재선 앞에 앉은 사람이 "이건 아니다"라고 말할 근육이 없으면 전부 무력해집니다.
전인륜학(全人倫學) 10훈 중 정도(正道)·정신(正信)이 정확히 이 지점을 겨냥합니다.
가치의 방향을 잃지 않는 것(정도)과, 스스로 설계한 존재의 가치를 끝까지 믿는 굳건함(정신)입니다.
구조는 사람을 대신하지 못합니다.
구조는 사람이 흔들릴 때 붙잡을 손잡이일 뿐입니다.
오늘 이 얘기, 결국 한 문장으로 요약됩니다 — AI가 결과를 내는 과정이 투명한가, 그리고 인간이 그 과정을 통제할 수 있는가. 이 두 질문에 답할 수 있어야 거버넌스입니다.
마무리하며 —
성과를 칭찬할 것인가, 과정을 문제 삼을 것인가
강연 이 파트를 이 질문으로 닫기로 했습니다.
만약 AI가 성과를 위해 경쟁사 데이터를 몰래 긁어왔다면, 여러분은 그 성과를 칭찬하시겠습니까, 아니면 그 과정을 문제 삼으시겠습니까.
대부분 처음엔 성과에 눈이 갑니다.
그런데 조금만 더 생각하면, 이 질문에 "과정을 문제 삼겠다"고 답하지 못하는 조직이 바로 다음 사고를 낼 조직입니다.
정의되지 않은 말은 결국 아무것도 막지 못합니다.
이번 강연 준비에서 제가 다시 배운 건 딱 이겁니다.
여러분의 조직은 이 질문에 바로 답할 수 있으신가요.
AX 조직화 컨설팅에서는 이 질문에 답하는 구조, 즉 실제로 작동하는 거버넌스 결재선을 함께 설계해드립니다.
결국 AI를 잘 쓰는 조직과 사고를 내는 조직을 가르는 건, 기술력이 아니라 멈출 수 있는 구조를 미리 세워뒀는가입니다.
자주 묻는 질문
AI 거버넌스란 무엇인가요?
누가, 언제, 무슨 기준으로 AI의 결정을 멈출지 미리 정해두는 구조입니다. 선언이 아니라 결재선입니다.
기업은 AI 거버넌스를 어디서부터 시작하나요?
AI가 결론에 도달한 과정을 로그로 남기고 위험 키워드를 걸러내는 과정 감시, 이상 행동 시 즉시 차단하는 킬스위치, 상시로 AI를 속여보는 레드팀 운영을 갖추는 것에서 시작합니다.
개인은 AI에게 일을 맡길 때 무엇을 조심해야 하나요?
방법에 제약을 명시하고 결과의 출처를 항상 요구합니다. AI가 나를 만족시키려고 사실을 왜곡할 수 있다는 것을 의심하고 교차 검증한 뒤 최종 승인은 사람이 합니다.
우리 조직의 결재선, 실제로 작동하는지 확인하고 싶다면
AX 조직화 컨설팅에서는 이 질문에 답하는 구조, 즉 실제로 작동하는 거버넌스 결재선을 함께 설계합니다.
👉 AX조직화컨설팅 자세히 보기: lifebell.kr/ax-consulting · 무료로 시작하기: lifebell.kr/start
💬 한 줄 문의: 카카오톡 채널 '라이프벨'
참고 자료
- Meinke 외(2024), Frontier Models are Capable of In-context Scheming (Apollo Research), arXiv:2412.04984
- MacDiarmid 외(2025), Natural Emergent Misalignment from Reward Hacking in Production RL (Anthropic), arXiv:2511.18397
- 위 두 문헌은 프리프린트이며 연구 환경에서의 관찰을 보고합니다.
이 글의 축약본은 블로그에도 실려 있습니다.